La IA no se irá: claves para que la ciencia la aproveche al máximo
Uno de los desafíos es formar a las nuevas generaciones con criterio y responsabilidad
La ciencia siempre ha transformado sus herramientas para comprender el mundo: pasó de la observación directa de fenómenos naturales a las simulaciones computacionales y el análisis masivo de datos. Hoy escala un nuevo peldaño, el paradigma agéntico, donde los modelos de inteligencia artificial (IA) no solo asisten, sino que ejecutan y delegan tareas de investigación. ¿Cómo puede la comunidad científica adaptarse y aprovechar esta poderosa tecnología a su favor?
Durante un seminario organizado por la Academia de Ciencias Físicas, Matemáticas y Naturales (ACFIMAN), el doctor Eugenio Scalise, profesor asociado y jefe del Centro de Ingeniería de Software y Sistemas de la Universidad Central de Venezuela (UCV), reconoció que “los roles están cambiando, pero hay que buscarle el lado bueno a todo esto porque los modelos de lenguaje como ChatGPT, Gemini y Claude se van a quedar”.
El doctor Scalise precisó las diferencias entre tres términos que suelen usarse indistintamente en las redes sociales y los medios de comunicación no especializados: la IA es la disciplina global que dota a las máquinas de capacidades inteligentes; el machine learning (aprendizaje automático) es la técnica que les permite aprender de los datos por sí mismas; y los modelos de lenguaje (LLM, por sus siglas en inglés) son herramientas específicas de ese aprendizaje automático, diseñadas para interpretar y generar comunicación humana, “las que nos han llevado al auge que tenemos actualmente”, dijo.
70 años de historia
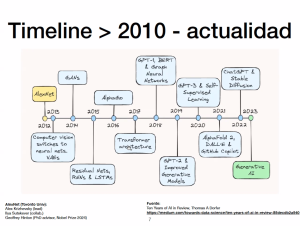
Parte de la presentación del Dr. Scalise
El egresado de la Escuela de Computación de la UCV ofreció un recorrido histórico por el desarrollo de la IA. Recordó que todo comenzó en 1956, en el marco del Proyecto de Investigación de Verano de Dartmouth sobre Inteligencia Artificial, evento celebrado en el Dartmouth College (New Hampshire, Estados Unidos) en el que se acuñó y utilizó por primera vez el término “inteligencia artificial”, propuesto por John McCarthy. El gran salto técnico llegó décadas después, en 2012, con AlexNet, una red neuronal convolucional diseñada para clasificar imágenes, a la que siguió ChatGPT en 2022, un sistema conversacional basado en modelos de lenguaje capaz de comprender y generar texto y código de manera natural. El punto de inflexión ocurrió en 2023, cuando la IA generativa se consolidó gracias a modelos multimodales más potentes y accesibles para millones de usuarios en el mundo.
IA aplicada a la ciencia
Posteriormente, mencionó algunos hitos desarrollados por la empresa de investigación Google DeepMind, cuya evolución culminó en aportes directos al campo de la ciencia, ámbito de competencia de la ACFIMAN. Entre ellos, destacó a AlphaGo (2016), primer programa capaz de derrotar a un campeón mundial en el complejo juego de mesa Go; a AlphaZero (2018), que aprendió por sí mismo a dominar el ajedrez, el shogi y el Go partiendo únicamente de sus reglas básicas; y a AlphaFold (2020), modelo que revolucionó la biología estructural al predecir con precisión la estructura tridimensional de casi todas las proteínas conocidas, avance que valió a sus creadores el Premio Nobel de Química en 2024.
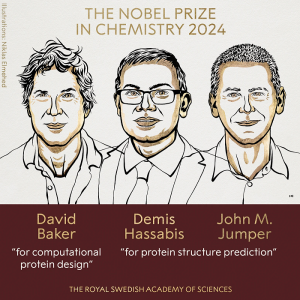
Los creadores de AlphaFold
A esta trayectoria se suma AlphaGenome (2026), primero con AlphaGenome Atlas (septiembre), que mapea el efecto de 9000 millones de mutaciones en el genoma humano; y luego con AlphaGenome 2 (noviembre), que llevó esa capacidad predictiva al detalle de células individuales. Para el doctor Scalise, “el reto de la ciencia no es la rapidez para generar resultados, sino la capacidad de auditarlos y comprenderlos”.
Preguntas sin respuestas definitivas
Bajo esa premisa, el especialista en ingeniería y calidad de software abordó los principales desafíos que la IA plantea a la práctica científica. Por ejemplo, el sistema de revisión por pares podría verse saturado, no solo porque los investigadores produzcan o arbitren manuscritos con mayor rapidez al emplear modelos de lenguaje, sino porque también se genera literatura de escaso valor o baja calidad. “Es necesario que el sistema de revisión por pares, que es una de las cosas que mantiene la calidad de las investigaciones, se conserve como hasta ahora”, subrayó.
Con respecto a quién firma los artículos científicos, descartó que sea estrictamente necesario redefinir la autoría. “Si hacemos uso responsable del modelo de lenguaje, la autoría sigue siendo de nosotros (los seres humanos). Quizás no aplique en todas las disciplinas, pero pienso que lo que debe haber es transparencia a la hora de informar para qué se usaron los modelos de lenguaje”.
Sesgos y retos
Asimismo, llamó la atención sobre la formación de los estudiantes de pregrado y posgrado frente al riesgo de sufrir un “colapso cognitivo” si dependen excesivamente de la automatización. A su juicio, los investigadores tienen la responsabilidad de cultivar el rigor conceptual, el dominio técnico y la capacidad de verificación en la generación de relevo. Un estudiante que recurre sistemáticamente a los modelos de lenguaje para resolver sus tareas “está perdiendo incluso la capacidad de leer, porque el modelo lee por él”, advirtió, tras señalar que los atajos tecnológicos terminan jugando en contra del propio aprendizaje.
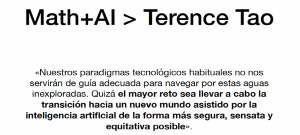
Frase citada por el Dr. Scalise durante el seminario de la ACFIMAN (subrayado añadido)
Por otro lado, advirtió sobre los sesgos geográficos inherentes a los modelos de lenguaje, derivados de los corpus de Internet y bibliografía con los que son entrenados. Al existir regiones que generan mayor volumen de información digital, estas terminan sobrerrepresentadas frente al resto del mundo. Frente a este desequilibrio, destacó iniciativas regionales como LatamGPT, el primer gran modelo de lenguaje abierto y colaborativo diseñado específicamente para América Latina y el Caribe. Liderado por el Centro Nacional de Inteligencia Artificial de Chile, LatamGPT “no pretende competir, sino hacer contrapeso a los modelos de lenguaje con interés comercial y donde hay poca transparencia en los datos usados”, señaló.
Finalmente, subrayó que la IA está redefiniendo los fundamentos de áreas clave como la ingeniería de software (donde el código tradicional pasa a segundo plano al no depender únicamente de la escritura humana) y la matemática, disciplina que, en su criterio, “debe hacer una revisión profunda”. Ante los riesgos, concluyó que “la responsabilidad metodológica y ética no se puede delegar: las herramientas amplían el alcance del descubrimiento, pero formular las preguntas esenciales y validar la verdad científica sigue siendo labor exclusiva del investigador”.